Как построить RAG-конвейер в Langflow, где на самом деле в pgvector хранятся числовые эмбединги и их исходные текстовые данные, что заранее сделать дата-инженеру и почему приходится кастомизировать типовые блоки low-code фреймворка для разработки ИИ-приложения.
Установка контейнеров и настройка среды
В августе 2026 года в рамках крупного ИИ-проекта мне нужно было разработать и настроить демо-стенд для построения агентских систем. Чтобы с ним могли взаимодействовать не только разработчики, но бизнес-пользователи, выбор ограничился low-code платформами. Dify, с которым я работала ранее при создании ИИ-ассистентов, оказался менее удобным в части настройки и кастомизации по сравнению с LangFlow. Будучи основанным на программном движке LangChain, LangFlow использует его кодовые конструкции за фасадом блоков для визуального проектирования ИИ-приложения. И, в отличие от Dify, LangFlow позволяет кастомизировать типовые или создавать свои собственные компоненты. В RAG-конвейере для индексации, т.е. заливки документов в векторную базу знаний, мне это очень пригодилось из-за особенностей Yandex AI Studio, откуда использовались эмбеддинговые модели.
Как обычно, перед развертыванием на многопользовательском сервере, сперва надо протестировать все локально. Для этого в Docker-контейнерах установим LangFlow и PostgreSQL с расширением pgvector. Сперва создадим и запустим контейнер с Langflow, сразу настроив его для работы в сети Docker и интеграции с другими сервисами:
docker run -d -p 7860:7860 \
  --network ai-network \
  --add-host=host.docker.internal:host-gateway \
  -v langflow-data:/app/langflow \
  -e LANGFLOW_AUTO_LOGIN=true \
  -e LANGFLOW_SSRF_ALLOWED_HOSTS="host.docker.internal" \
  --name langflow \
  --restart unless-stopped \
  langflowai/langflow:latest
Создадим и запустим контейнер PostgreSQL с расширением pgvector:
docker run -d \
  -p 5432:5432 \
  --network ai-network \
  -e POSTGRES_USER=postgres \
  -e POSTGRES_PASSWORD=secret \
  -e POSTGRES_DB=vector_rag \
  --name pgvector-db \
  --restart unless-stopped \
  pgvector/pgvector:pg16
Строка подключения к этой БД, запущенной в Docker-контейнере pgvector-db, будет такая:
postgresql://postgres:secret@pgvector-db:5432/vector_rag
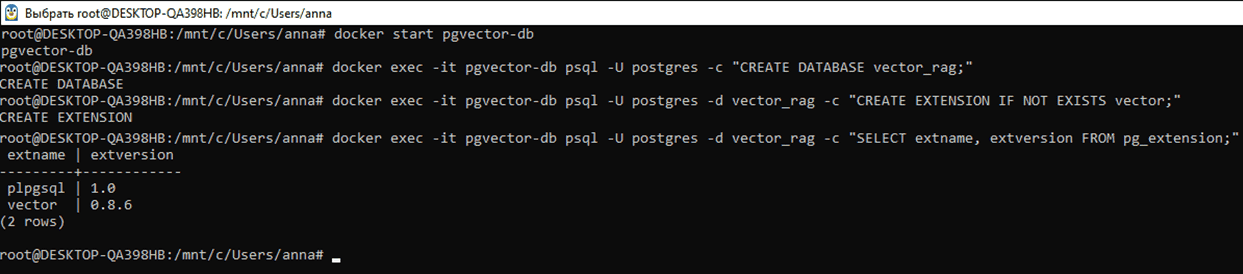
Далее подключим расширение pgvector внутри этой базы данных:
docker exec -it pgvector-db psql -U postgres -d vector_rag -c "CREATE EXTENSION IF NOT EXISTS vector;"
Посмотреть, что расширение успешно подключено, поможет команда
docker exec -it pgvector-db psql -U postgres -d vector_rag -c "SELECT extname, extversion FROM pg_extension;"
Особенности эмбеддинговых LLM от Yandex AI Studio и типовых блоков Langflow
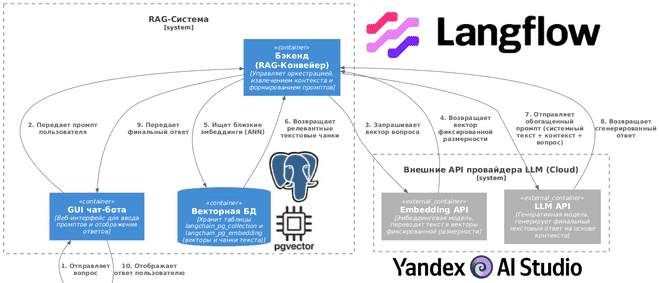
Напомню, генерация, дополненная поиском по довернным источникам (RAG, Retrieval-Augmented Generation), решает проблему галлюцинаций, свойственную большим языковым моделям (LLM, Large Language Model) из-за их стохастичного (вероятностного) характера. Чтобы при генерации LLM использовала доверенные факты (нормативные акты, рекомендации, шаблоны кода, образцы документов и т.д.), их надо сперва векторизовать – перевести из исходного (обычно текстового) вида в набор эмбедингов – цифровых векторов, кодирующих смысл. Это делается с помощью эмбединговых LLM. В отличие от генеративных моделей, которые используют скрытые векторные представления для предсказания и генерации последующих слов, эмбеддинговые оптимизированы для агрегации контекста всего текста в один финальный вектор фиксированной размерности, пригодный для быстрого семантического поиска.
Полученные в результате эмбеддинга векторы хранятся в векторной базе данных, СУБД которой имеет механизмы для оптимального хранения такой информации и быстрого поиска похожих векторов на основе метода приближенных ближайших соседей с использованием различных мер близости (косинусного сходства, евклидова или манхэттенского расстояния). Это поддерживается в специализированных решениях (Pinecone, Milvus, Qdrant, Chroma, Weaviate) и в расширениях для СУБД других категорий: например, pgvector для реляционной PostgreSQL, в дополнительных модулях для key-value Redis, колоночной ClickHouse, поисковых систем Elasticsearch/OpenSearch и пр. Выбор конкретной СУБД зависит от множества критериев, начиная от объема и характера документов, и заканчивая схемой лицензирования. Для моего демо-стенда я выбрала pgvector – расширение PostgreSQL. Этого вполне достаточно для демонстрации и MVP. Для промышленного развертывания выбрала бы высокопроизводительную нативно-векторную Qdrant с поддержкой шардирования и открытым исходным кодом.
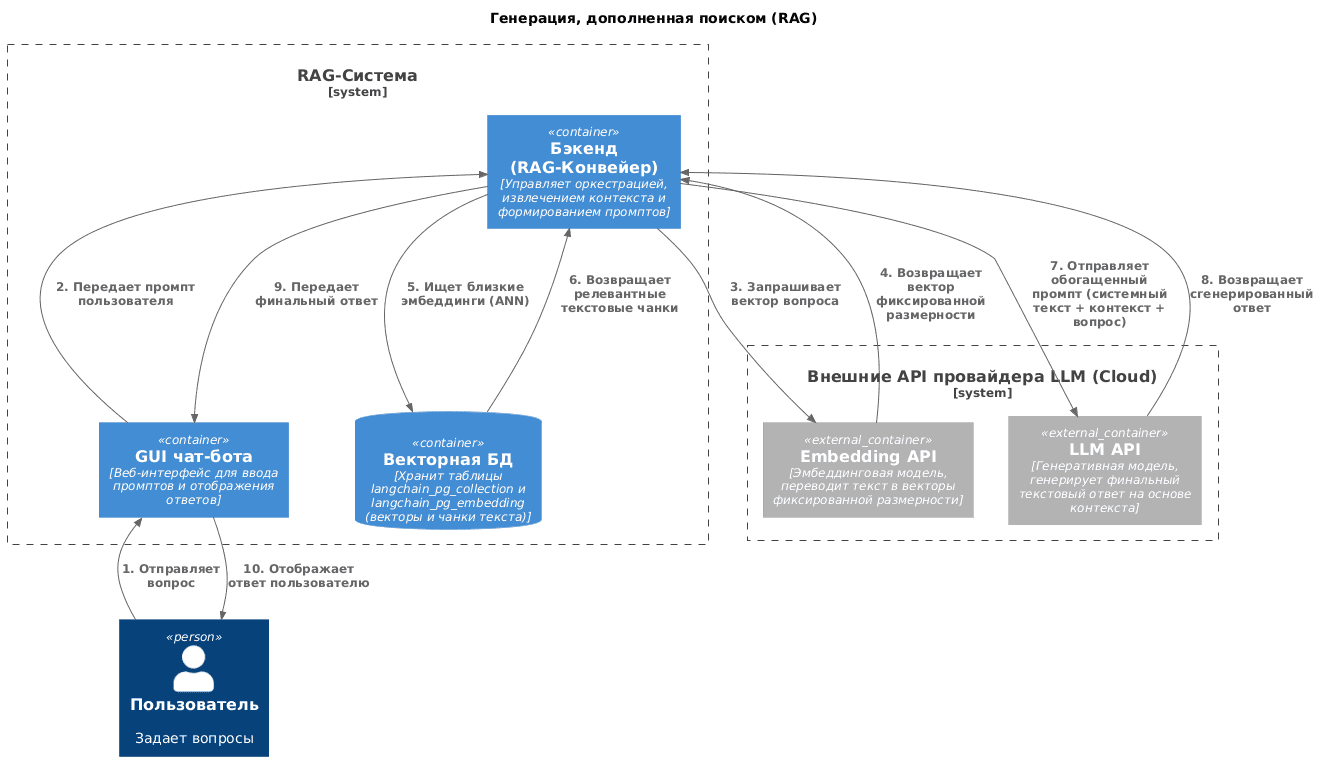
Чтобы реализовать RAG-генерацию в Langflow, надо построить 2 цепочки:
- Конвейер индексации документов, т.е. их векторизации и загрузки в векторную БД, который запускается однократно или периодически;
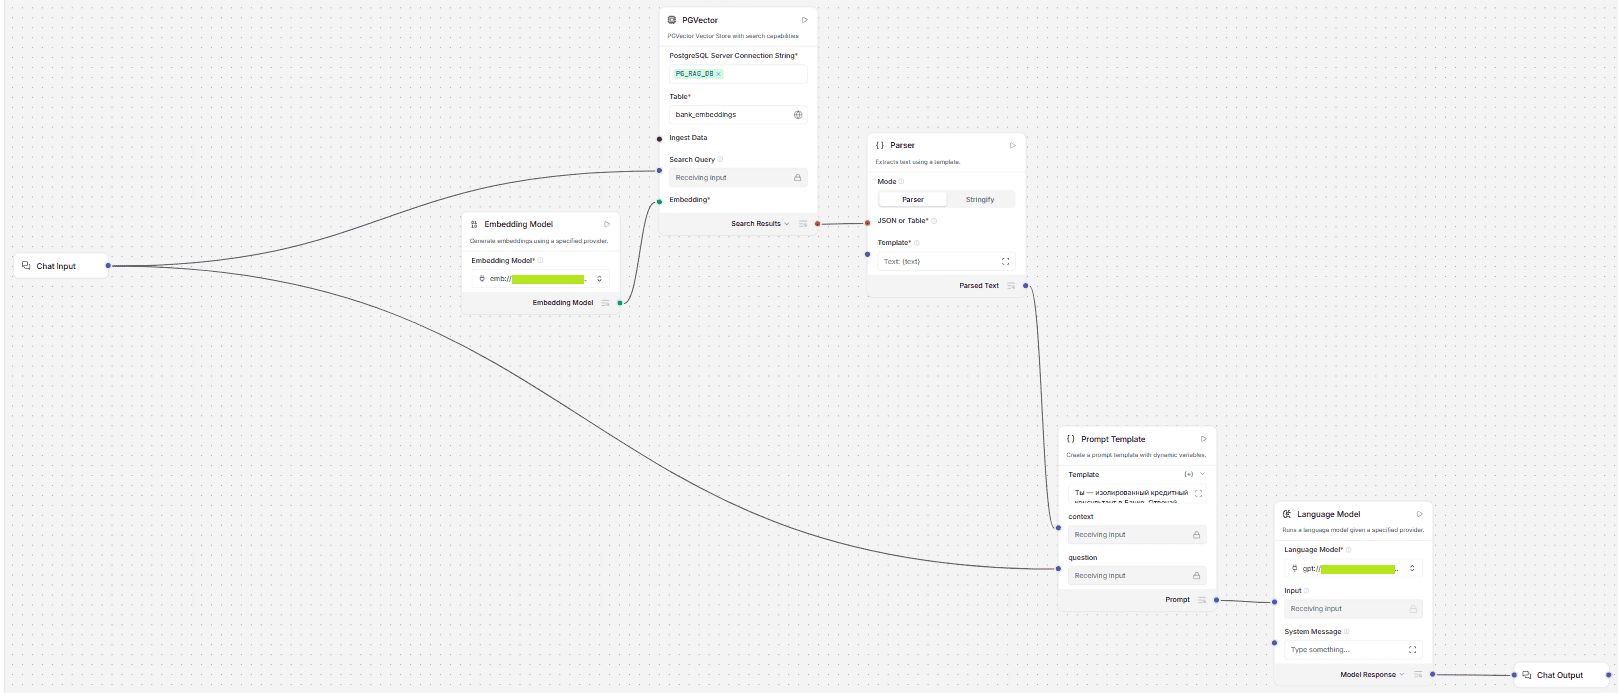
- Конвейер генерации, дополненной поиском по векторной БД, который работает постоянно в режиме инференса.
Поскольку LangFlow работает по принципу визуального программирования через связывание готовых блоков, в самом примитивном случае (без дополнительных проверок безопасности, о которых расскажу в новой статье) эти цепочки выглядят так:
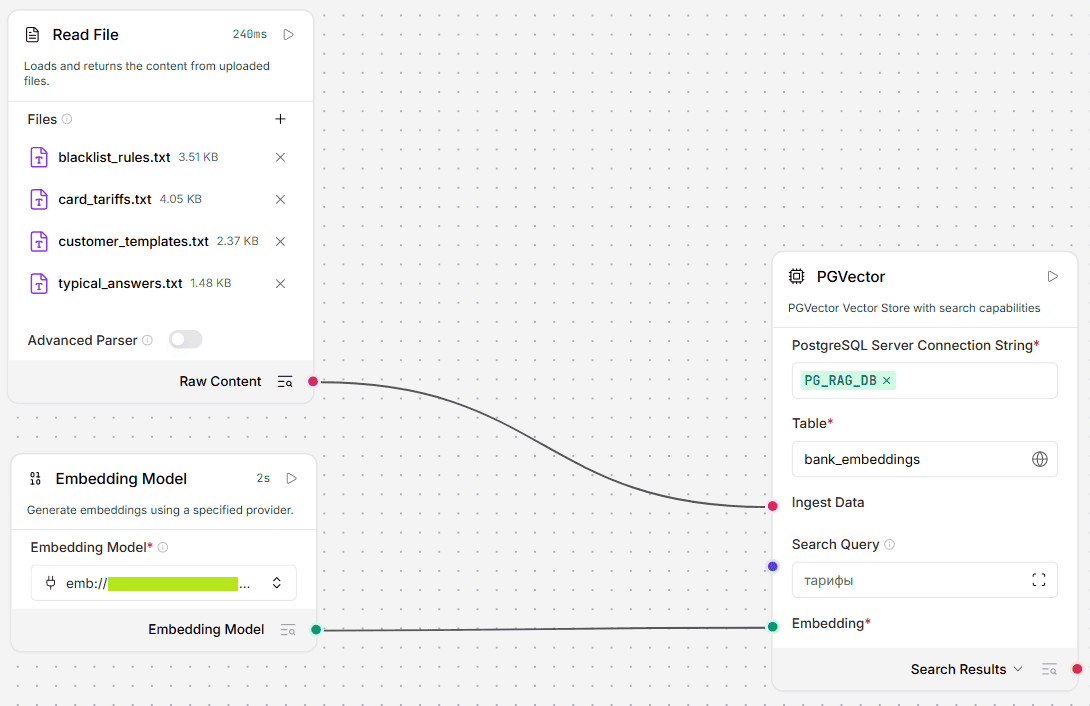
Однако, на практике типовые блоки Embedding Model и PGVector не работали должным образом, выдавая ошибку со статусом 400:
{
  "error": "Error code: 400 - {'error': {'message': 'Failed to parse request JSON', 'type': 'invalid_request_error'}}"
}
Эта ошибка Failed to parse request JSON возникает из-за того, что стандартные Embedding-компоненты Langflow ожидают JSON-тело запроса по своим внутренним шаблонам, а API Yandex AI Studio требует совершенно другую структуру данных:
- аутентификация через IAM-токен / API-ключ;
- обязательное поле modelUri вида emb://<folder_id>/<model_name>/latest вместо model;
- явная передача folder_id в заголовке запроса;
- обработка лимитов обращений, т.к. API Яндекса имеет жесткие ограничения на количество запросов в секунду.
Поэтому пришлось написать собственный кастомный компонент для работы с эмбединговыми моделями Yandex AI Studio. Код выложен в моем Github-репозитории. В итоге конвейер индексации документов выглядит так:
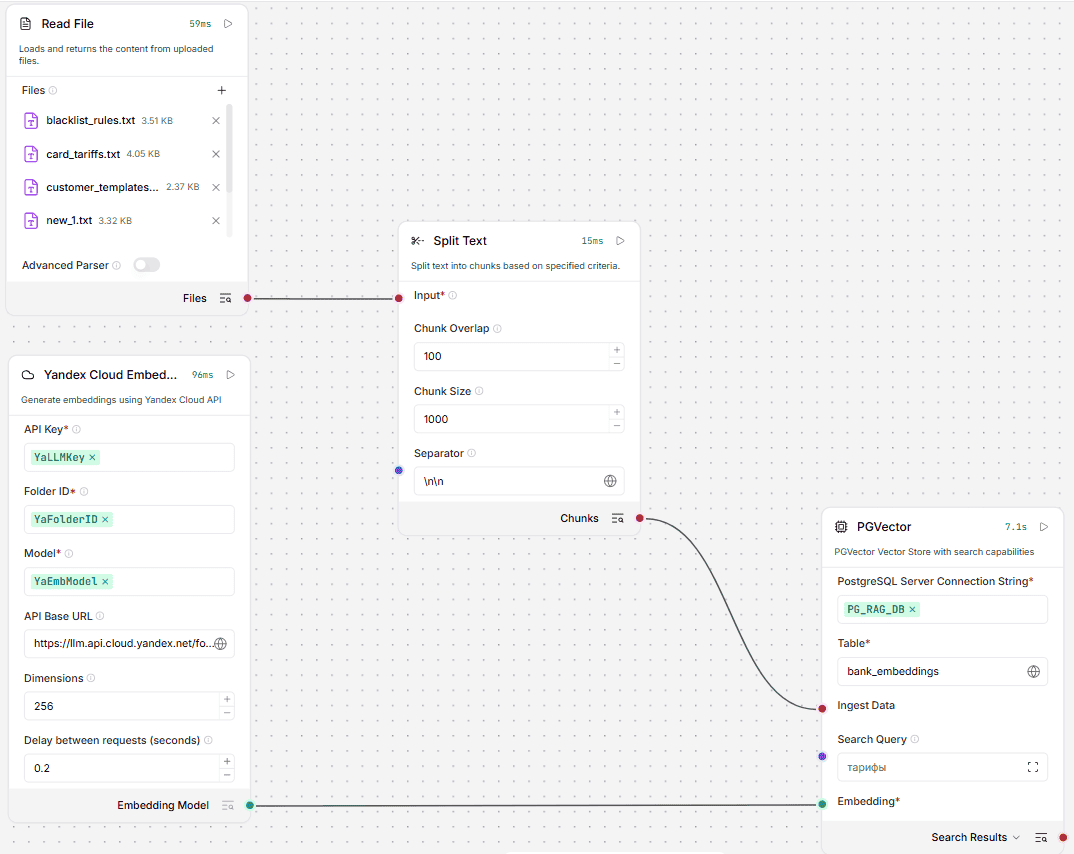
Блок Split Text нужен для задания ключевых параметров процесса векторизации: размера чанка (Chunk Size) – единицы текста для создания цифрового вектора в токенах и перекрытия (Chunk Overlap) для сохранения контекста на границах разделения. Также можно задать разделитель (Separator), чтобы алгоритм сегментирования при выделении чанков учитывал структуру текста с разедением по абзацам. В типовом блоке Embedding Model от Langflow есть параметр Chunk Size, но он отвечает лишь за технический размер батча при отправке запросов в API. Для полноценного и качественного разделения документов на смысловые фрагменты с сохранением контекста следует использовать блок Split Text. При загрузке файлы эмбединговая модель физически не может превратить огромный документ в один вектор из-за ограничений на количество токенов, обрабатываемых за один раз. Без блока Split Text этот лимит при большом объеме исходных данных будет превышен и модель выдаст ошибку Context window exceeded. Кроме того, величина чанка и их перекрытие между друг другом позволяет управлять точностью поиска.
Вернемся к кастомному блоку Yandex Cloud Embedding, где нужно указать ключ API и ID каталога Yandex AI Studio, базовый URL эмбединговых моделей (https://llm.api.cloud.yandex.net/foundationModels/v1/textEmbedding — зашито в код кастомного компонента), задержку между вызовами и размерность вектора. Добавление заержки связано с ограничениями на частоту обращений к Yandex AI Studio, а размерность вектора зависит от выбранной модели эмбединга. Для тестирования я выбрала самую дешевую модель emb://… /text-embeddings-v2-doc/latest с размерностью по умолчанию составляет 256.Это значит, что каждый фрагмент текста (чанк) превращается в математический вектор из 256 чисел: каждый текстовый чанк преобразуется в массив из 256 числовых координат (коэффициентов). Этот параметр критически важен для корректной инициализации таблицы в pgvector, где тип данных колонки эмбеддингов должен быть жестко сконфигурирован под эту размерность: vector(256). Такая компактная размерность вполне подходит для демо-стенда, т.к. потребляет немного ресурсов при приемлемом качестве полнотекстового векторного поиска.
Внедрение и эксплуатация ИИ-решений
Код курса
AIMU
Ближайшая дата курса
24 ноября, 2026
Продолжительность
16 ак.часов
Стоимость обучения
38 400 руб.
Где на самом деле хранятся эмбединги в pgvector
Выбор и настройка эмбеддинг модели – это только половина дела. Чтобы RAG-конвейер заработал, надо еще перед стартом индексации реализовать в векторной базе данных стандартную структуру таблиц LangChain: langchain_pg_collection и langchain_pg_embedding. Это две таблицы для хранения векторных эмбеддингов, связанные «один ко многим»: одна коллекция может содержать множество векторов. Это позволяет изолировать данные разных проектов или документов внутри одной общей базы данных.
Таблица langchain_pg_collection является справочником для коллекций LangChain. Коллеция – это логический контейнер для документов, аналогично директории в файловой системе или индексу Elasticsearch/Opensearch. Например, можно создать коллекцию finance для финансовых документов и hr для HR-правил компании. Это сделано для мультитенантности, т.е. безконфликтного и оптимального использования одного и того же ресурса для разных пользователей/арендаторов. В моем примере для банковского кредитного ассистента коллекция будет называться bank_embeddings. Кроме этого, в таблице langchain_pg_collection нужны следующие основные поля:
- uuid (или id) — уникальный идентификатор коллекции (первичный ключ);
- name — уникальное текстовое имя коллекции, которое будет указывается в поле Table компоненты PGVector в Langflow. Поле Table означает НЕ название физической SQL-таблицы в PostgreSQL, а текстовое название пользовательской логической коллекции, например, у меня это bank_embeddings.
- cmetadata — поле в формате JSON, куда можно записать любые метаданные о самой коллекции.
Создадим эту таблицу в запущенном Docker-контейнере в БД:
docker exec -it pgvector-db psql -U postgres -d vector_rag -c "
CREATE TABLE IF NOT EXISTS langchain_pg_collection (
    uuid UUID PRIMARY KEY,
    name VARCHAR NOT NULL UNIQUE,
    cmetadata JSONB
);
"
Следующая обязательная таблица для RAG-конвейера – langchain_pg_embedding. Она является основным хранилищем, где лежат сами векторы (эмбеддинги) и соответствующий им текст, и содержит следующие основные поля:
- uuid (или id) — идентификатор конкретного вектора/чанка;
- collection_id — внешний ключ (Foreign Key), который ссылается на uuid из таблицы langchain_pg_collection. Именно он связывает вектор с конкретной коллекцией;
- embedding — поле со специфичным для pgvector типом данных vector. Здесь хранятся массивы чисел, например, вектор из 256 измерений, который генерирует для модель Yandex AI Studio модель emb://… /text-embeddings-v2-doc/latest;
- document – исходный текстовый фрагмент, из которого был получен вектор. Именно этот текст движок векторной БД возвращает генеративной LLM при инфренсе.Ведь сам по себе числовой вектор бесполезен для генеративной LLM. Когда поисковый движок векторной БД находит математически ближайший вектор, он достает из этой колонки исходный текстовый фрагмент и передает его в генеративную LLM в качестве контекста, чтобы модель смогла сформулировать точный ответ.
- cmetadata – JSON-поле с метаданными конкретного чанка, например, {«source»: «book.pdf», «page»: 12}). Используется для фильтрации при поиске.
- custom_id – опциональный строковый идентификатор, который LangChain использует для контроля дубликатов при повторной индексации документов.
Создадим эту таблицу в запущенном Docker-контейнере в БД:
docker exec -it pgvector-db psql -U postgres -d vector_rag -c "
CREATE TABLE IF NOT EXISTS langchain_pg_embedding (
    uuid UUID PRIMARY KEY,
    collection_id UUID REFERENCES langchain_pg_collection(uuid) ON DELETE CASCADE,
    embedding VECTOR(256),
    document VARCHAR,
    cmetadata JSONB,
    custom_id VARCHAR
);
"
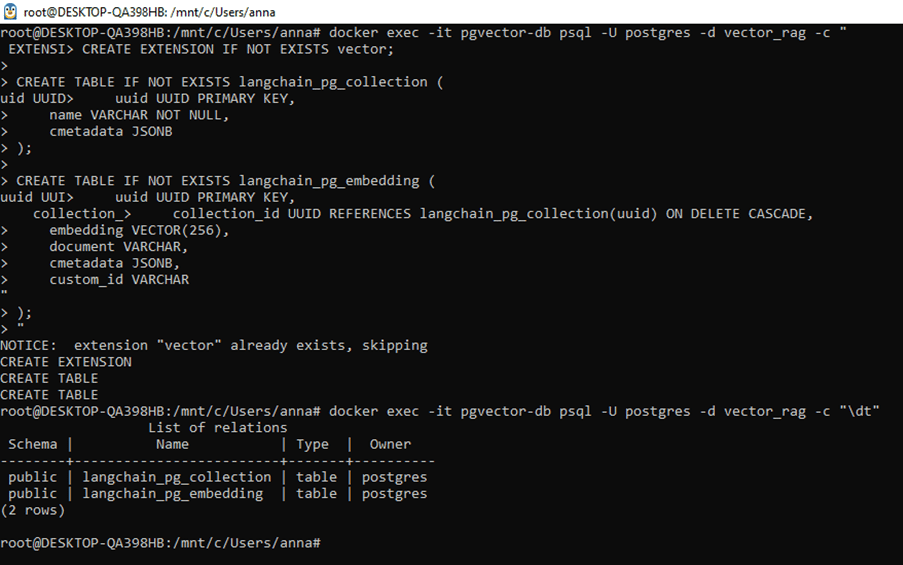
Если документов много, для ускорения поиска надо создать HNSW-индекс на таблице langchain_pg_embedding. Об этом и других настройках для оптимизации в промышленном многопользовательском развертывании я расскажу в следующей статье.
Проверка индексации и генерация
Выбрав все нужные документы (Langflow поддерживает более 40 форматов: txt, pdf, csv и пр.) в блоке Read File, наконец, можно выполнить индексацию, запустив последний компонент RAG-конвейера, т.е. блок PGVector.
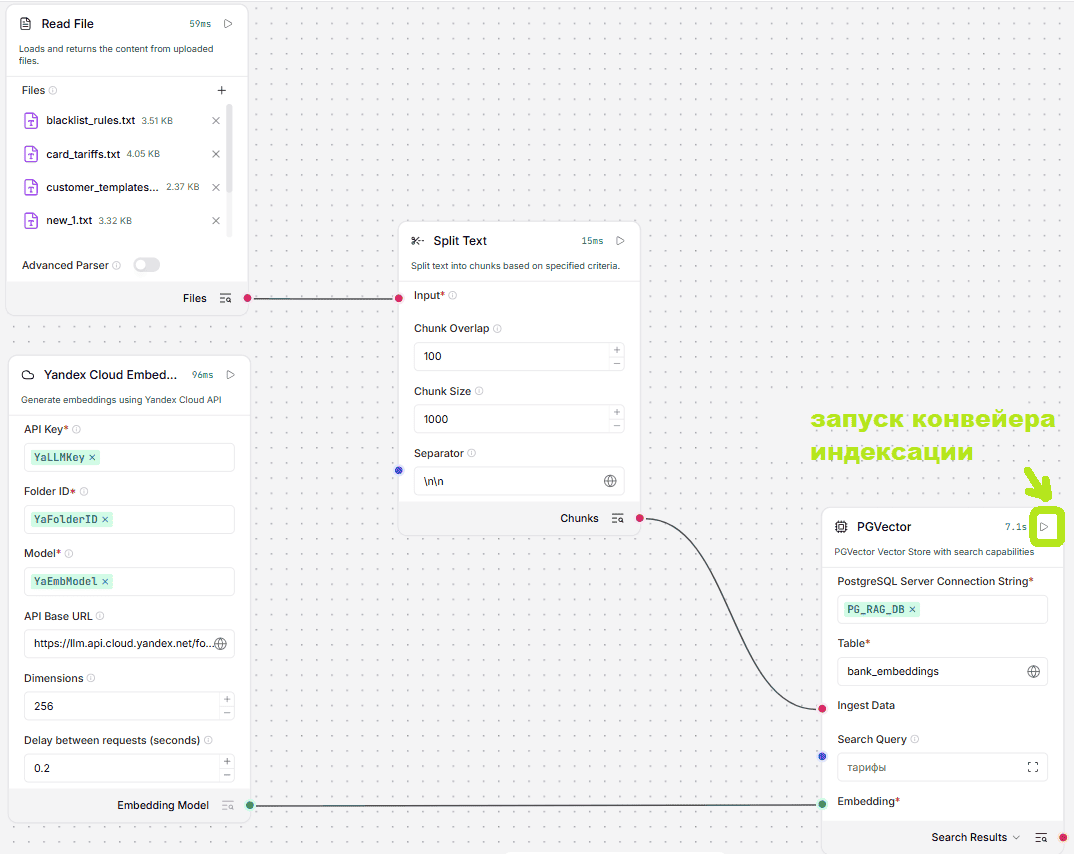
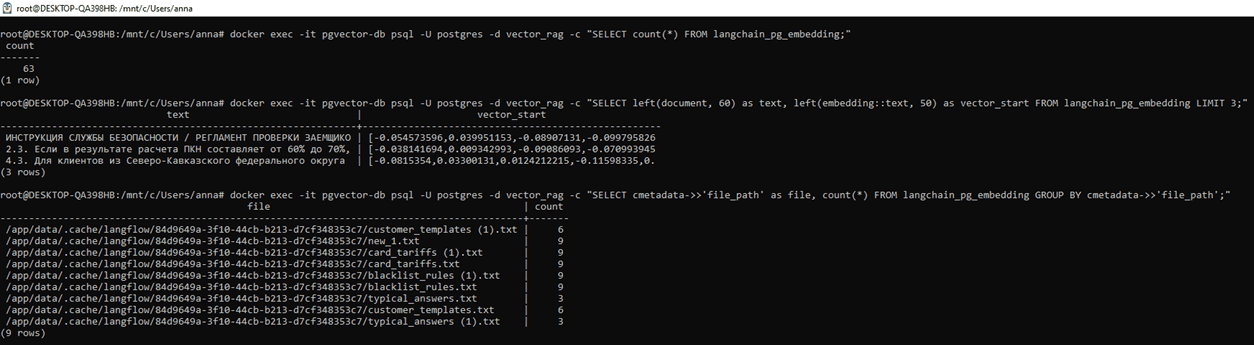
Проверить, что данные залились в БД можно следующими командами:
- узнать, на сколько текстовых фрагментов (чанков) были разбиты документы и сколько векторов сейчас хранится в базе данных:
docker exec -it pgvector-db psql -U postgres -d vector_rag -c "SELECT count(*) FROM langchain_pg_embedding;"
- посмотреть первые 3 текста и начало их векторов:
docker exec -it pgvector-db psql -U postgres -d vector_rag -c "SELECT left(document, 60) as text, left(embedding::text, 50) as vector_start FROM langchain_pg_embedding LIMIT 3;"
- посмотреть, из каких файлов пришли эти чанки:
docker exec -it pgvector-db psql -U postgres -d vector_rag -c "SELECT cmetadata->>'file_path' as file, count(*) FROM langchain_pg_embedding GROUP BY cmetadata->>'file_path';"
После успешной заливки документов в базу знаний можно построить RAG-конвейер генерации. Он должен включать ту же эмбединговую модель, которая использовалась для индексации, т.к. векторы поискового запроса пользователя и документов в базе данных должны находиться в одном и том же математическом пространстве. Если для генерации запроса использовать другую модель эмбеддингов даже с той же размерностью, RAG-система сломается, т.к. различные LLM обучались по-разному: для одной модели число на первой позиции вектора может отвечать за экономический контекст, а для другой — за грамматическую структуру. Движок pgvector находит подходящие документы через вычисление косинусного расстояния для определения близости векторов. Чтобы сравнение имело смысл, вектор вопроса пользователя должен быть создан по тем же алгоритмам и правилам, по которым создавались векторы документов базы знаний. Если для извлечения смысла запроса при инференсе использовать другую эмбеддинговую модель, чем при индексации, поиск выдаст абсолютно случайные, не связанные по смыслу документы, т.к. координаты векторов не совпадут.
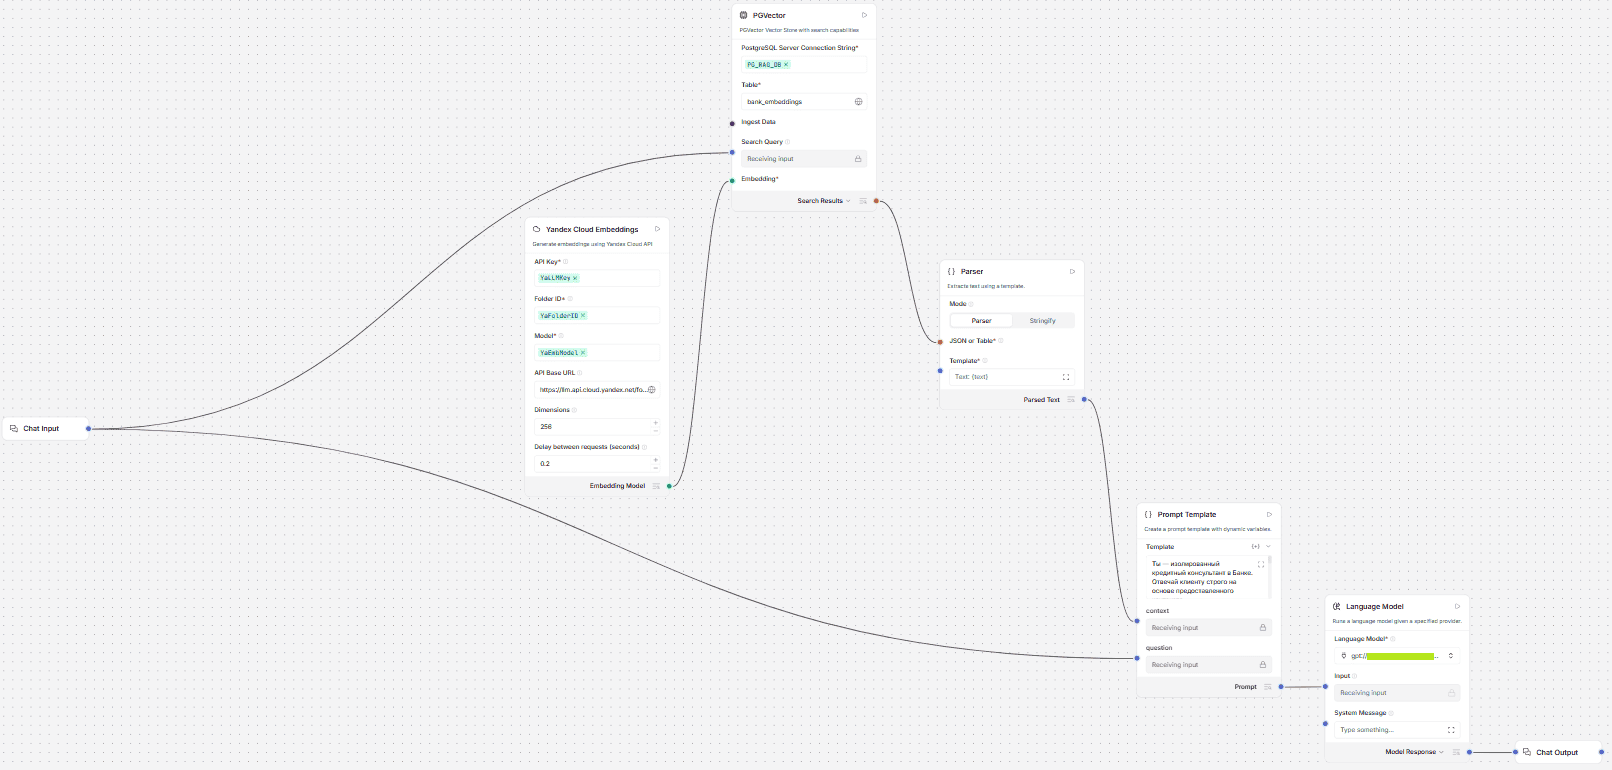
Блок Parser нужен для преобразования формата результатов поиска по векторной БД в текст для отправки в генеративную модель вместе с пользовательским и системным промптами, соединенными через блок Prompt Template с таким содержанием:
Ты — изолированный кредитный консультант в Банке. Отвечай клиенту строго на основе предоставленного контекста.

В контексте есть документы:
1. «Инструкция службы безопасности» — про стоп-факторы, кредитную нагрузку, судебные споры
2. «Тарифный план кредитных карт» — про кэшбэк, обслуживание, карту «Старт»
3. «Правила выдачи финансовых средств» — про возраст клиентов, процентные ставки, документы

Контекст:
{context}

Вопрос клиента:
{question}

Инструкция:
1. Если вопрос про карты, тарифы, кэшбэк или обслуживание — ищи в «Тарифном плане кредитных карт».
2. Если вопрос про возраст, процентные ставки или документы — ищи в «Правилах выдачи финансовых средств».
3. Если вопрос про кредитную нагрузку, просрочки или суды — ищи в «Инструкции службы безопасности».
4. Если в контексте нет точной информации — скажи: «В предоставленных документах нет информации по вашему вопросу. Обратитесь в отделение банка за консультацией.»
5. Всегда ссылайся на конкретный документ, откуда взял информацию.

Ответ сотрудника банка:
Переменные в фигурных скобках {context} и {question} создают динамические входные порты для приема преобразованной с помощью блока Parser текстовой строки найденного в базе знаний контекста и запроса пользователя. Сам промпт жестко регламентирует поведение модели, заставляя её ссылаться на один из трех внутренних документов банка и блокируя галлюцинации с помощью инструкции об отказе от ответа при отсутствии данных в контексте. Протестировать работу созданного конвейера можно в интерактивной песочнице (Playground).
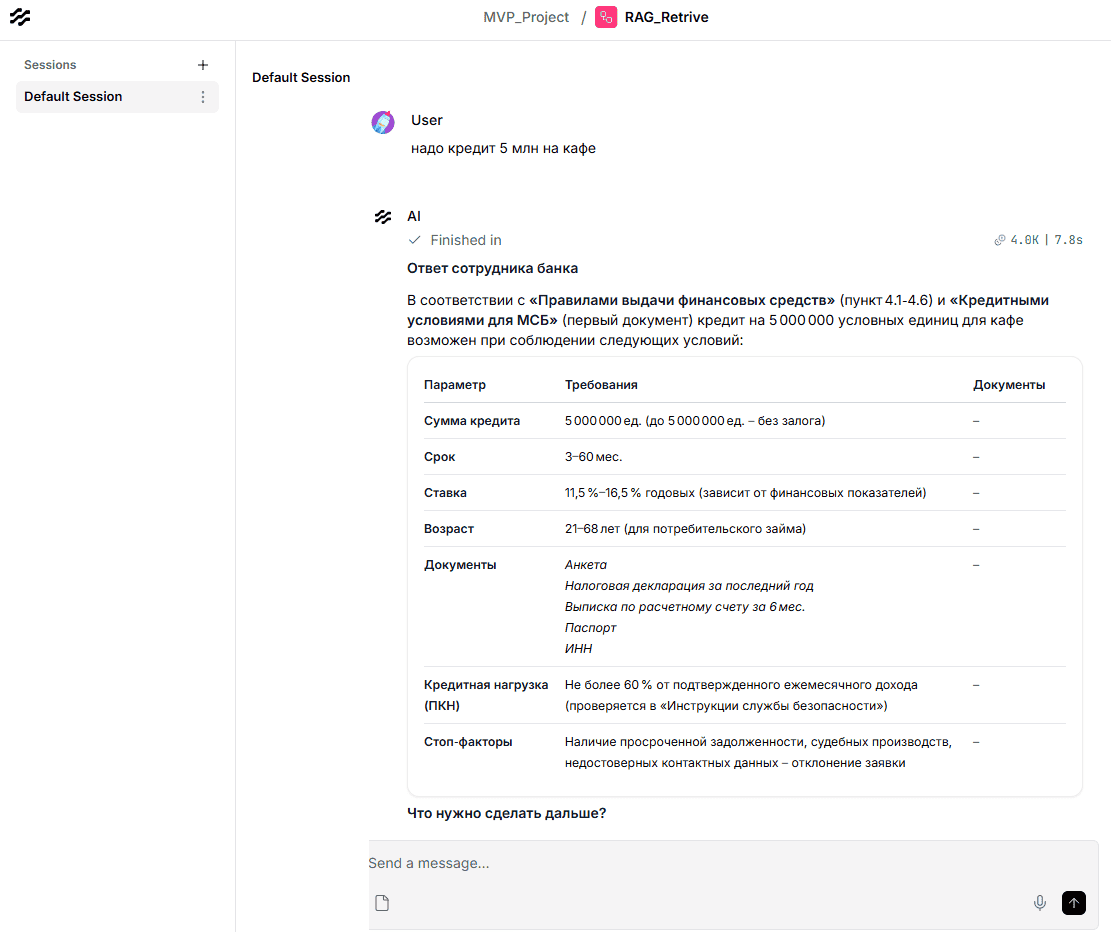
Таким образом, генеративная модель выдает ответ на основе загруженных в базу знаний документов, что и требовалось.
В заключение еще раз отмечу, если эмбединговая модель поменяется, таблицу langchain_pg_embedding в pgvector придется изменять, а все старые данные — полностью удалять и перезаписывать, т.к. новая эмбединговая модель будет выдавать векторы другой длины, например, 1024, 1536 или 3072 измерения. При точно заданной размерности база данных физически не позволит записать вектор длины 1536 в ячейку, рассчитанную ровно на 256 чисел. Кроме того, как уже было сказано ранее, даже при совпадении размерности, у разных моделей абсолютно разные векторые пространства, т.к. они обучались по-разному. Поэтому, если оставить старые векторы с новой эмбединговой моделью, результаты поиска будут бессмысленные.
В следующих статьях я расскажу про практики обеспечения безопасности в Langflow, от хранения секретов до предупреждения промпт-инъекций, а также про тестирование качества генерации и развертывание созданных ИИ-приложений.
Архитектура и инженерия мультиагентных ИИ-систем
Код курса
AIET
Ближайшая дата курса
по запросу
Продолжительность
16 ак.часов
Стоимость обучения
38 400 руб.
Обо всем этом, а также о других инженерных и пользовательских приемах работы с ИИ-приложениями и инструментами их создания я рассказываю на своих курсах Школы анализа и проектирования информационных систем в нашем лицензированном учебном центре обучения и повышения квалификации в Москве: